场景:工厂水表月报(读数 / 用水量),旧 OA 表单与新抄表系统双数据源并行期合并。技术栈:帆软 FineReport + Oracle,报表走 READOA 只读账号取数。本文以"提问 → 排查 → 结论"的对话时间线还原全过程,用户提问原文照录。
〇、对话时间线总览
| 轮次 | 用户反馈 | 定性 | 关键动作 |
|---|---|---|---|
| 1 | 读数(函数版)能查,用水量(函数版)报 ORA-00904 | 函数"半可见"之谜 | 怀疑连接不一致 / 对象不存在 |
| 2 | all_objects 查空;用水量无函数版可用;读数也报错了 | ❌ 函数从未建成 | 改内联,弃函数路线 |
| 3 | 优化版两数据集都通了;9 月 27 日列头排序前置 | 新问题:排序 + 拆行 | dump 诊断、行数摸底 |
| 4 | dump 证明日期干净;源头清理权限不足 | ❌ 假说被推翻 | 诊断先行,避免错误 UPDATE |
| 5 | 部署日期清洗版后,8、9 月排序仍错 | 两个独立问题坐实 | 列头排序设置 + 对称清洗版 |
| 6 | 防呆版换上后两个数据集都查不到数据 | ❌ 占位符事故 | 空 CTE 定位,防呆完整版重发 |
| 7 | "这两个版本有什么区别?我是小白" | 复盘教学 | 逐块对比 + 名词卡 + 比喻 |
一、需求背景与目标
工厂的水表数据原本只有一个来源:OA 表单系统(主表 formtable_main_328 + 明细表 formtable_main_328_dt1),每天各表位手工录入,历史积累约 8 年。8 月下旬新抄表系统上线,数据进入新表 uf_water_report,但旧表并未立刻停用——新旧系统并行了一段时间。
并行期带来三类问题:
| 问题 | 表现 |
|---|---|
| 数据分裂 | 同一块水表,8 月下旬之前的数据在旧表、之后在新表,报表上看不到完整曲线 |
| 重复记账 | 切换重叠期,同一天同一块表两个系统都有记录,直接叠加会算重 |
| 名称污染 | 新系统表位名带 &t:、>、全角尖括号〈〉、不可见空格等脏字符,与旧表写法对不上 |
最终需求: 一张报表同时看到新旧两套数据;旧表为准;重叠期同一块表只算一次;表位名称无论怎么脏,都能归到同一行;日期列头严格升序。
二、方案设计:合并骨架
最终数据 = 旧表当月数据(全部保留,权威来源)
         ∪ 新表当月数据(去掉自身重复后,凡旧表已有的 → 丢弃)
判重键定为 日期 + 部门(location2) + 表位(location)——这三者必须"洗干净了再比"。日期口径沿用原报表:读数含月初前一天(startime - 1,用于算第一天的用水量),用水量从 startime 当天起算;月份参数 ${yearmonth} 从结账表 uf_monthly_balance 换算起止日期。
预告: 这个骨架后来从头到尾没有变过,变的只是"清洗"和"性能"这两层皮——而坑,也几乎全埋在这两层里。
三、过程实录(含提问原文与截图)
第 1 轮:ORA-00904 之谜 —— "一个函数,半个可见"
👤 我的提问(第 1 轮) 1. 表读数(函数版),正常查询到数据。但用水量(同样替换)函数版,会报错。 2. 先设日期列"升序",已经设置。
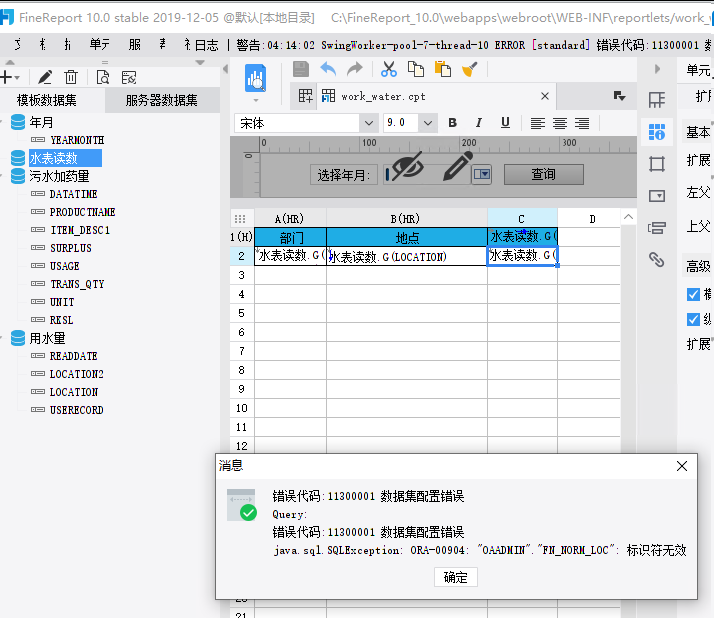
🧑🔧 当时排查: 同一个数据库会话里,函数要么都可见、要么都不可见,"读数能查、用水量报错"在逻辑上不可能 → 差异只能出在两个数据集绑定的数据连接不同,或"读数能通"是假象。给出动作:① 对比两数据集的连接;② 用 all_objects 验函数存在性;③ 顺手给出无函数版"用水量",并确认日期列头"升序"设置要点(选对横向扩展格、两个 sheet 都设、保存)。
第 2 轮:all_objects 空集 —— 函数从未建成
👤 我的提问(第 2 轮) 1. select owner, object_name, object_type, status from all_objects where object_name in ('FN_NORM_LOC', 'fn_norm_loc'); 在 PL/SQL 上查询到空数据。 2. 无函数版「用水量」(立即可用),可以正常使用。 3. 现在发现 水表读数(函数版)报错了。
✅ 结论:
all_objects返回空 = 任何 schema 下都不存在 FN_NORM_LOC。所谓"读数(函数版)能查通"是假象(当时预览的实际是未保存的旧 SQL)。真凶:函数体里要清洗的字符串>、&t:中的&被 PL/SQL Developer 当作替换变量吞掉,CREATE 语句根本没按原样执行。
🧑🔧 动作: 彻底放弃函数路线,水表读数同样换成"无函数内联版";备选方案留档——函数体内用 chr(38) 拼 &、用"程序窗口"而非 SQL 窗口执行。
第 3 轮:优化版跑通 + 9 月 27 日排序前置
👤 我的提问(第 3 轮) 1. 现在使用了水表读数(优化版)和用水量(同构优化版),帆软报表能正常查询到数据了。 2. 行数摸底,结果如下:新表总行数 3060|旧主表行数 3043|旧明细行数 109513 3. 现在帆软报表查询结果页面,发现其他月份日期都正常排序,只有 9 月份,这个 9 月 27 日排序前置了。其他都没问题。
🧑🔧 当时判断(后被推翻): 行数解读——旧明细 109513 ÷ 旧主表 3043 ≈ 36 块表/天,数据量并不大,印证此前的超时是执行计划问题而非规模问题。对 09-27 前置给出的第一假说:日期前有不可见字符(空格/Tab 的 ASCII 小于 '2',升序会排最前),并给出 dump 诊断 SQL。同时注意到 09-27 列在可见行里全是空值,提示该列属于更下方的某块表。
⚠️ 注意: "其他月份都正常"此时被当成了排序设置生效的证据——第 5 轮证明这纯属巧合。
第 4 轮:dump 实锤"日期是干净的" + 只读账号封死源头治理
👤 我的提问(第 4 轮) 1. 诊断①结果:SRC=新表,METERDATE=2026-09-27,DMP=Typ=96 Len=10 CharacterSet=ZHS16GBK: 32,30,32,36,2d,30,39,2d,32,37,CNT=77;诊断②报错。 2. 源头清理(先备份再 update),我执行后提示权限不足。 3. 把日期也纳入同一套清洗的水表读数和用水量 SQL 语句,我还没替换,等你分析了 1 和 2 后,我再做决定。
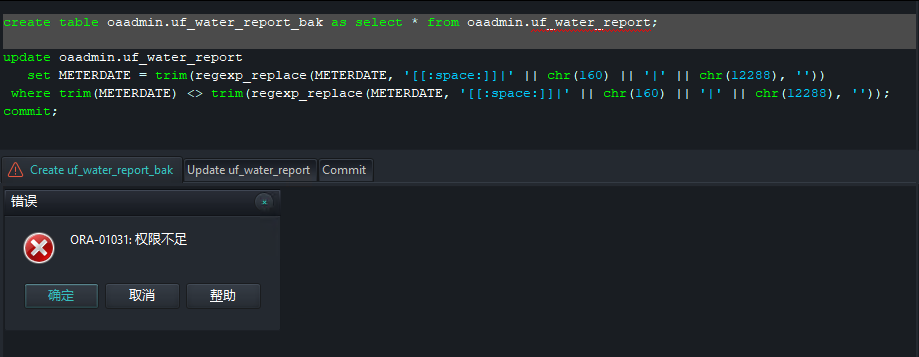
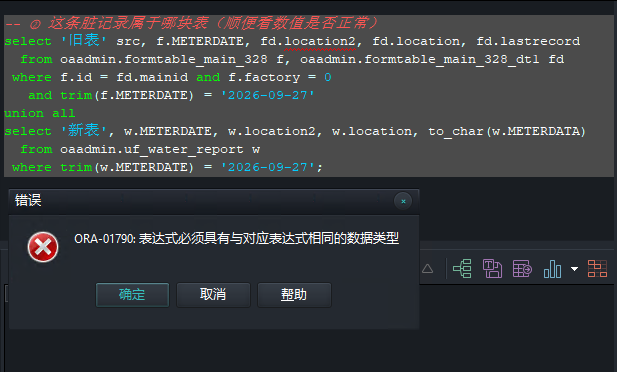
🧑🔧 三个结论: ① dump 逐字节翻译 32,30,32,36,2d,30,39,2d,32,37 = "2026-09-27",一个多余字符都没有,脏字符假说撤销(但诊断①有盲区:trim(=) 匹配不到 Tab/chr(160) 变体,不能就此断定全库干净);② 诊断②报错为 ORA-01790:UNION ALL 两侧类型不一致(NUMBER vs to_char),且 trim(=) 有盲区,改 like '%9-27%' 连变体一起抓;③ READOA = 只读账号,源头 UPDATE 不可行 → SQL 层清洗升级为唯一防线(转交 OA 管理员做源头治理,报表不依赖它)。
✅ 要点: 这次是"诊断先行"救了一次错误的 UPDATE——若当时直接按假说改数据,77 行好数据就会被白白"清洗"一遍。
第 5 轮:部署日期清洗版后,8、9 月排序仍错
👤 我的提问(第 5 轮) 直接部署日期清洗版(两个数据集都换)后,发现 8 月和 9 月日期排序还是有错误,其他月份正常。
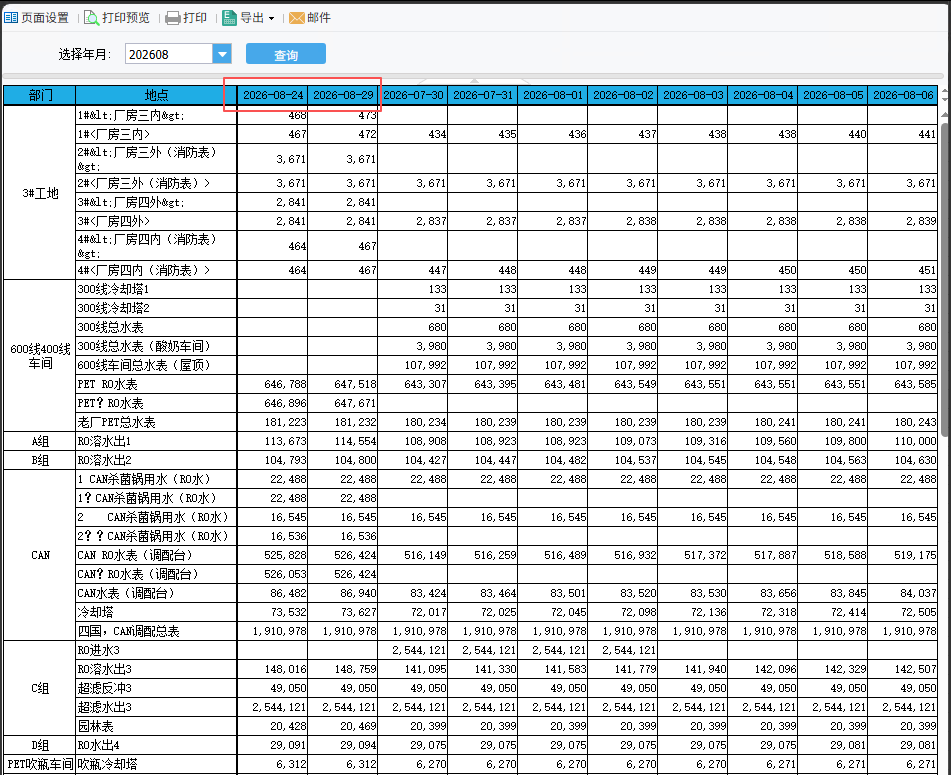
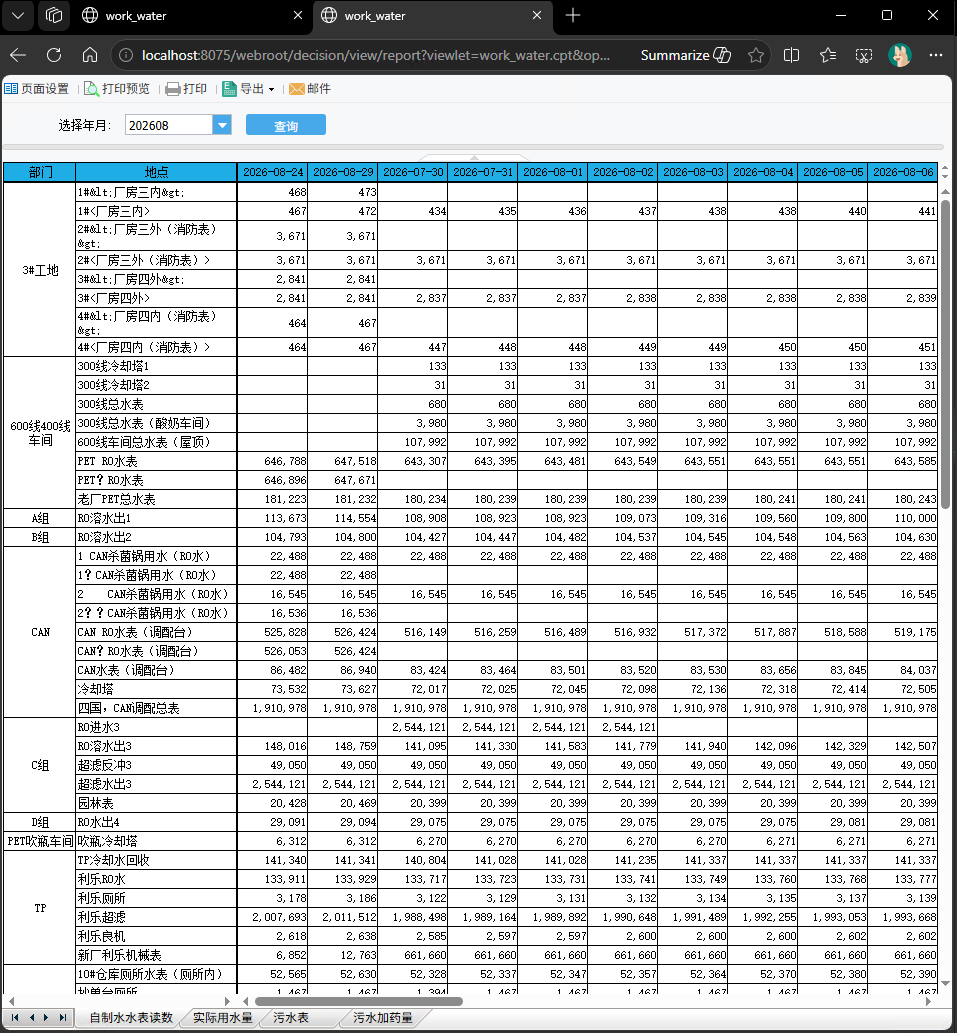
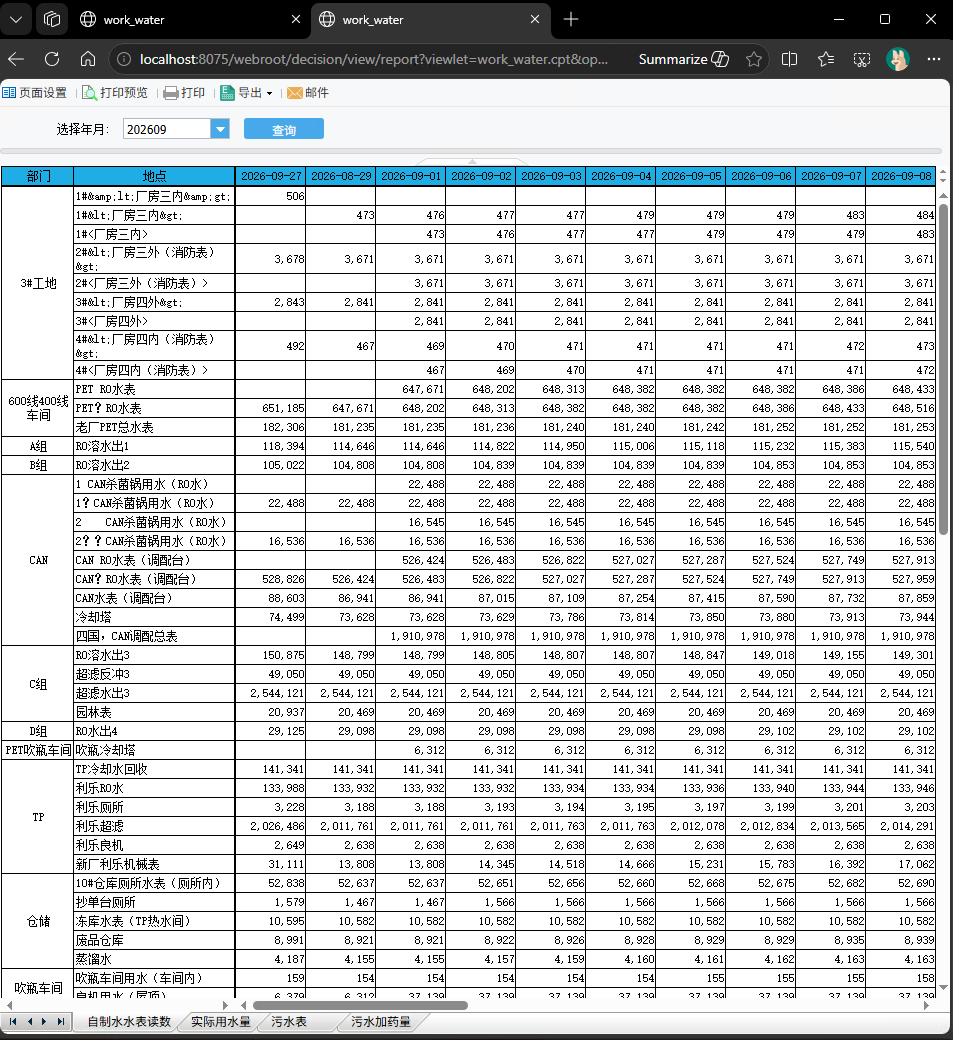
✅ 两张截图坐实两个独立问题: ① 列头"升序"从未真正生效——只要生效,'2026-07-30' 字典序必然小于 '2026-08-24',07-30 必须排第一。列头实际按"数据出现顺序"展开:旧 SQL 恰好 order by mainid(≈按日期),其他月份"正常"纯属巧合;新 SQL 按部门排序后,新表独有表位(字典序最小)排最前,它们仅有的 08-24、08-29 被最先登记进列头,乱序现形。 ② 判重失败 + 同表拆两行——成对行就是证据。复盘承认两个错:上一版清洗规则缩水(
bad只剩空白字符类,把>|<|&t:|&t:弄丢了);更早的设计缺陷是只洗新表显示名、旧表显示原样,两边名字对不上,新日期永远另起一行。
🧑🔧 动作: 确立终极原则——日期、部门、表位,无论新旧表、无论用于判重还是显示,全部过同一套清洗(对称清洗版);列头排序三步(选对横向扩展格→升序→保存+Ctrl+F5,附"临时改降序"自检法);并给出 distinct location 盘点 SQL 兜底。副作用预告:旧行名也会变成清洗后的样子,这是让同表两行合并的必要代价。
第 6 轮:占位符事故 —— "太离谱了,查不到数据"
👤 我的提问(第 6 轮) 用水量(完整版,整体替换)和水表读数(完整版,与上一条一致,一并贴出防止版本漂移)改后都查不到数据,太离谱了。
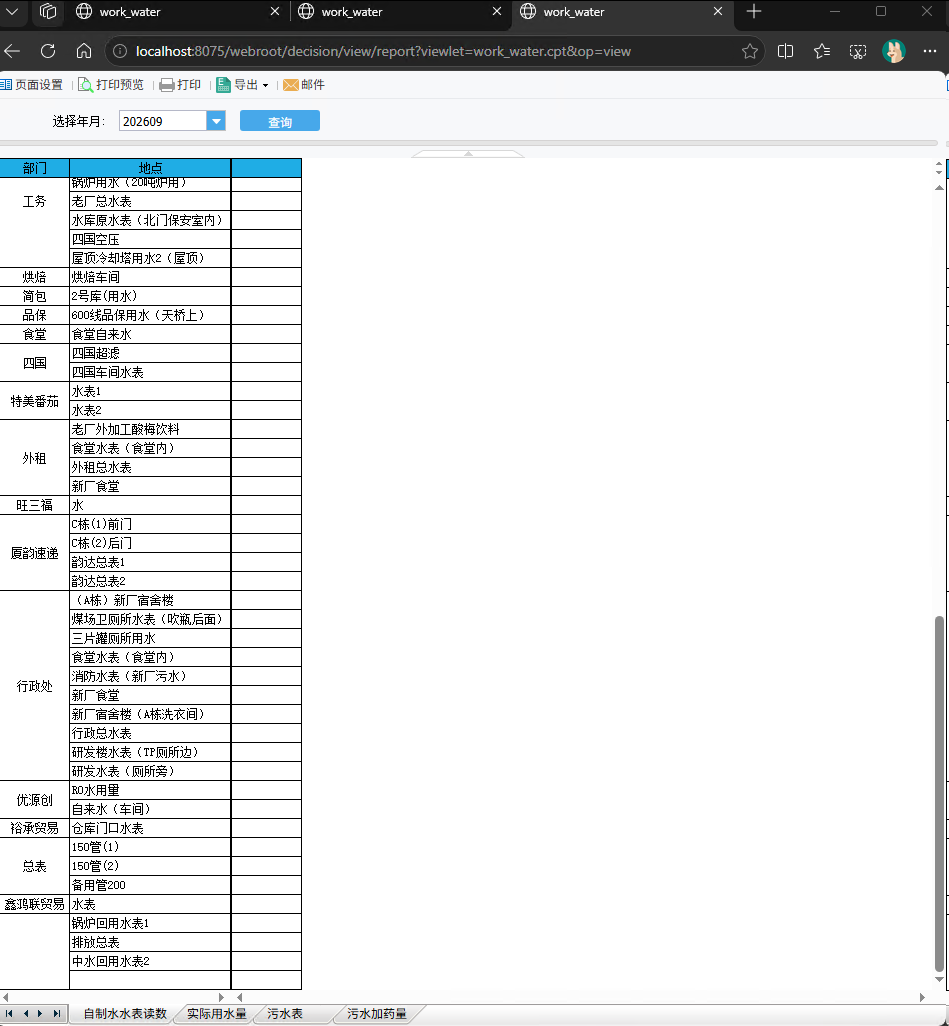
✅ 实锤就在用户随手贴的 txt 附件里: 用水量 SQL 开头是
with p as ( /* 与上面完全相同的 s/e/bad 三列 */ ),——上一轮交付时偷懒写了"照抄上面"的占位注释,被字面粘贴。空 CTE 必然语法报错;报错的数据集在报表页面上不弹窗,只表现为"查不到数据"——行标签是模板里别的内容,所以看起来"行在数空"。
🧑🔧 动作: ① 手术式检查:看 with p as ( 括号内第一行是否为 select to_date(startime...;② 三步隔离:数据集预览看完整报错文本 → 写死 '202609' 验证参数绑定 → 保存模板 + 关多余标签页 + Ctrl+F5;③ 重发防呆完整版:零占位符、& 一律 chr(38)、全角字符直接写字面量、不用任何未在用户环境验证过的构件(unistr 等);④ 保底回退方案:把 bad 两行换回跑通过的旧写法做二分。
第 7 轮:小白之问 —— 两个版本到底差在哪
👤 我的提问(第 7 轮) (贴出原版水表读数/用水量 SQL 与防呆完整版两对 SQL)这两个版本有什么区别?修改了哪些代码?能做一个详细的对比吗?我是一个小白,需要你解释清楚。
完整对比见第五章——这也是本文最适合收藏的部分。
四、踩坑案例集(10 个坑)
坑 #1:& 被 PL/SQL Developer 当成替换变量 —— 函数"建成了"其实是幻觉
- 现象: 归一化函数 fn_norm_loc"创建成功",甚至有一段时间读数数据集"查通了"。
- 真因: 函数体要清洗的
>、&t:里有&,SQL 窗口把它当替换变量,弹框要值或静默吞掉,CREATE 从未按原样执行。 - 修复:
-- 方法一:工具→首选项→SQL窗口 关闭变量替换;或执行前 set define off
-- 方法二:函数体内用 chr(38) 拼 &,彻底绕开
amp constant varchar2(1) := chr(38);
v := replace(v, amp||'gt;', '');
✅ 教训: 含
&的 SQL 在任何客户端先想替换变量这茬;"能跑"不等于"跑的是你以为的那段 SQL"。
坑 #2:ORA-00904 标识符无效 —— all_objects 一锤定音
- 现象: 同一函数,一个数据集"能用"、另一个报 ORA-00904。
- 真因: 函数根本不存在(坑 #1 的直接后果)。
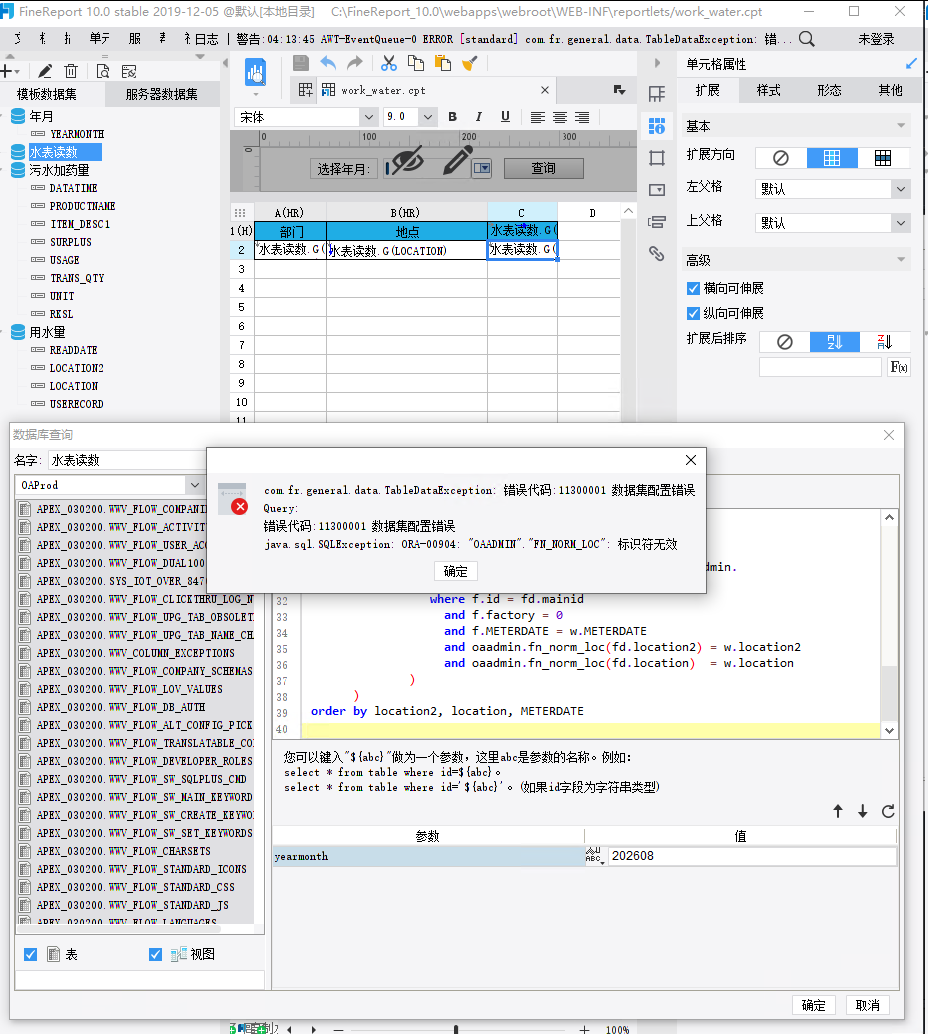
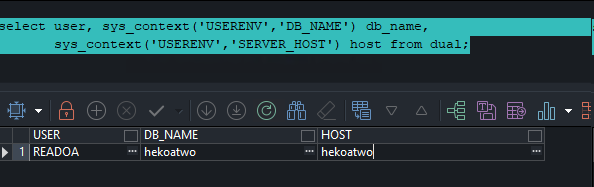
- 同库确认三件套:
user / sys_context('USERENV','DB_NAME') / SERVER_HOST,帆软与 PL/SQL 同库(READOA @ hekoatwo),排除"建错库"。
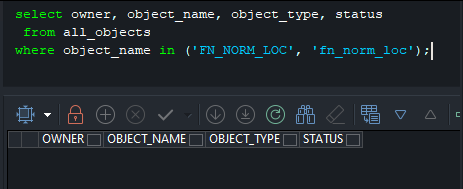
- 修复: 弃函数,全面内联。
✅ 教训: 对象存在性找
all_objects当裁判;两数据集行为不一致时,先怀疑连接不一致或对象不存在。
坑 #3:SQL 执行超时 —— 函数包裹的连接键毁掉执行计划
- 现象: 内联清洗版上线即报"很抱歉,sql执行时间过长触发保护机制……"。
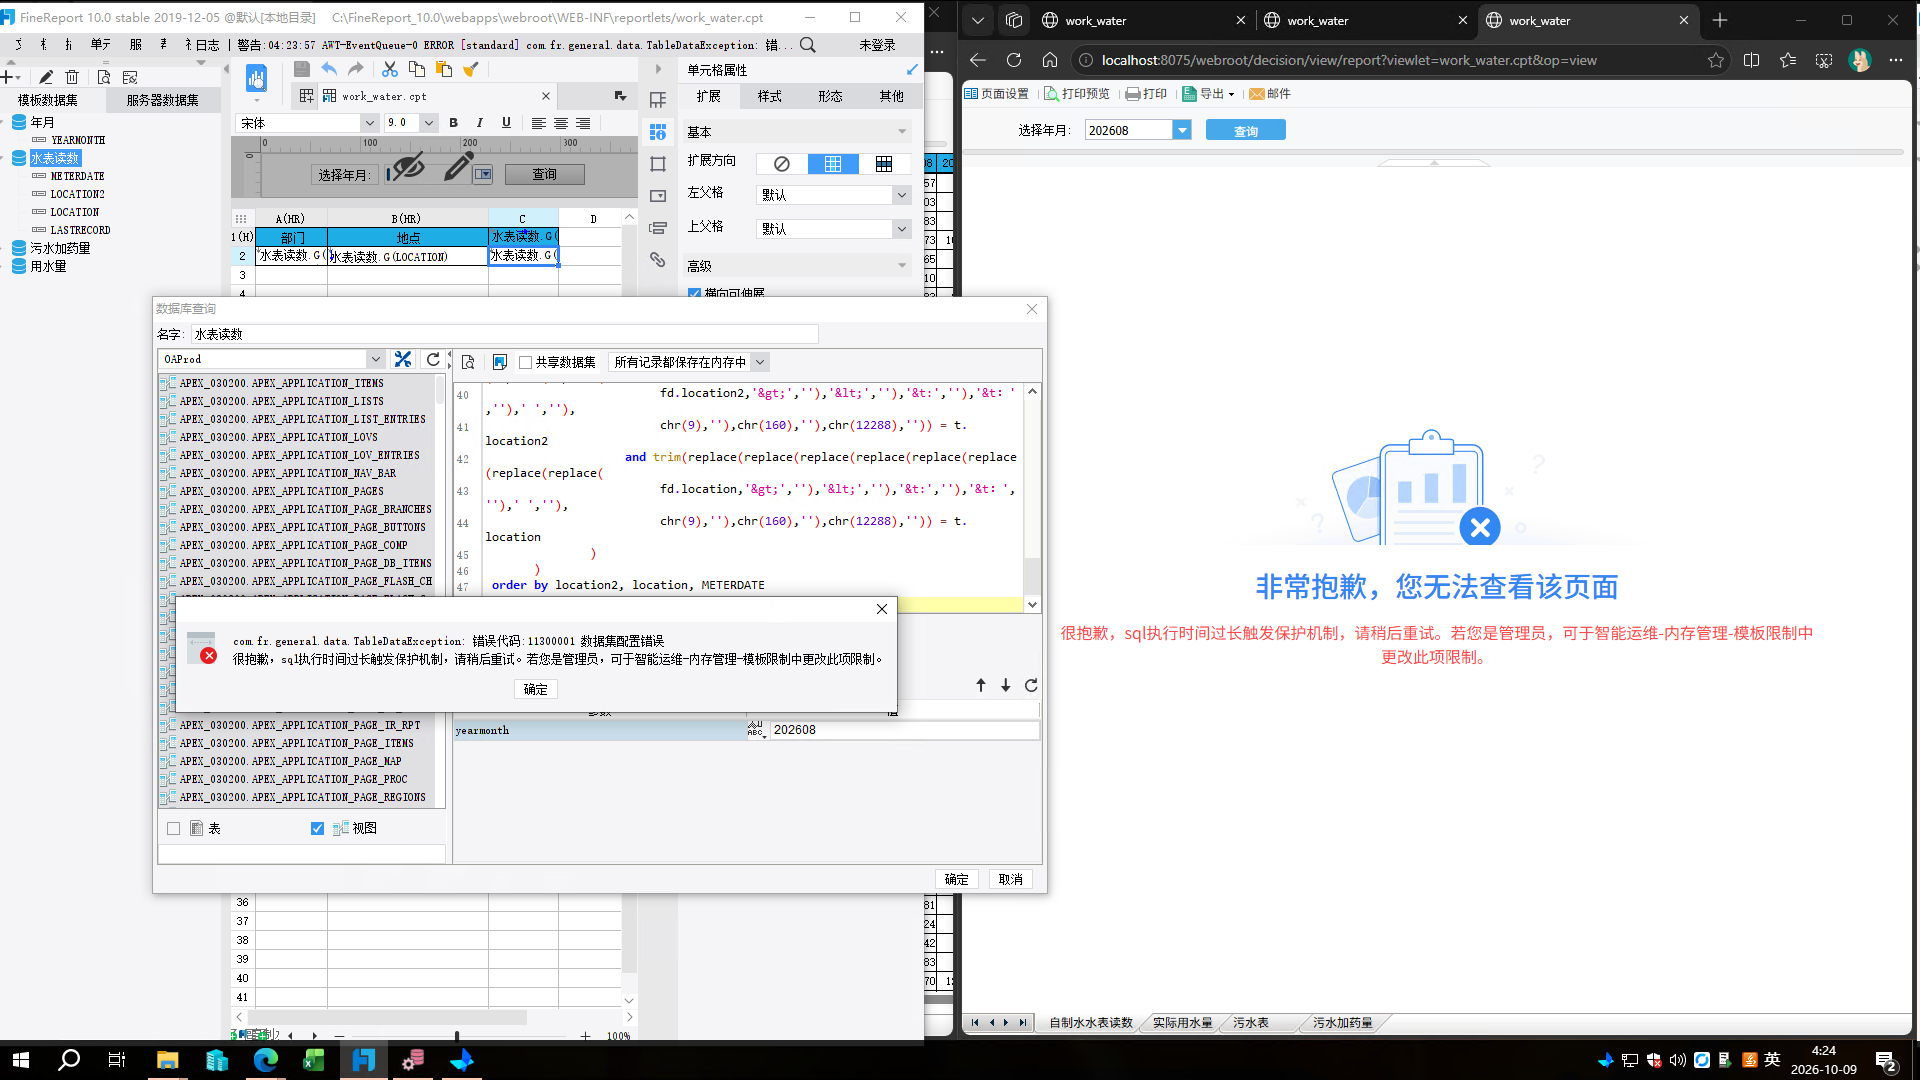
- 真因: NOT EXISTS 连接键被 8 层 replace 包裹 → 索引失效、行数估算失真 → 反连接劣化为"新表每行 × 旧表全历史扫"。
- 修复(性能三件套): 旧表先按月过滤;清洗后键
distinct+/*+ materialize */物化成小名单 old_keys;8 层 replace 收敛为一个 regexp_replace。
✅ 教训: 连接键上套函数是性能杀手;"先过滤、先归一、先物化"做在关联之前。帆软的执行时限只是保险丝,不是解决方案。
坑 #4:帆软列头"原序"的正常是巧合,不是正确
- 现象: 8 月列头 08-24 排在 07-30 前面,但"其他月份都正常"。
- 真因: 日期格扩展顺序=原序(按数据出现先后登记列头),旧 SQL 恰好按日期序出数,所以平时"看着正常";新 SQL 按部门排序后新表独有日期被最先登记,乱序现形。
- 修复: 选中横向扩展的日期格 → 扩展 → 排序=升序 → 保存模板 → 浏览器 Ctrl+F5;两个 sheet 都要设。
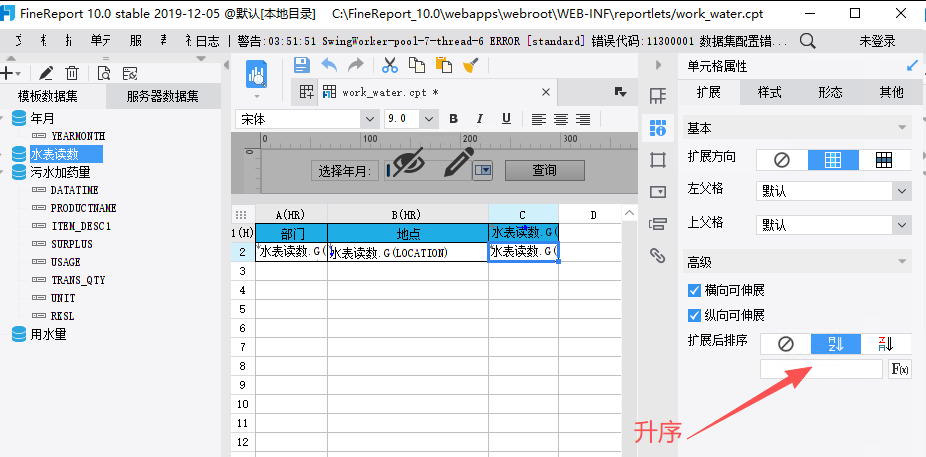
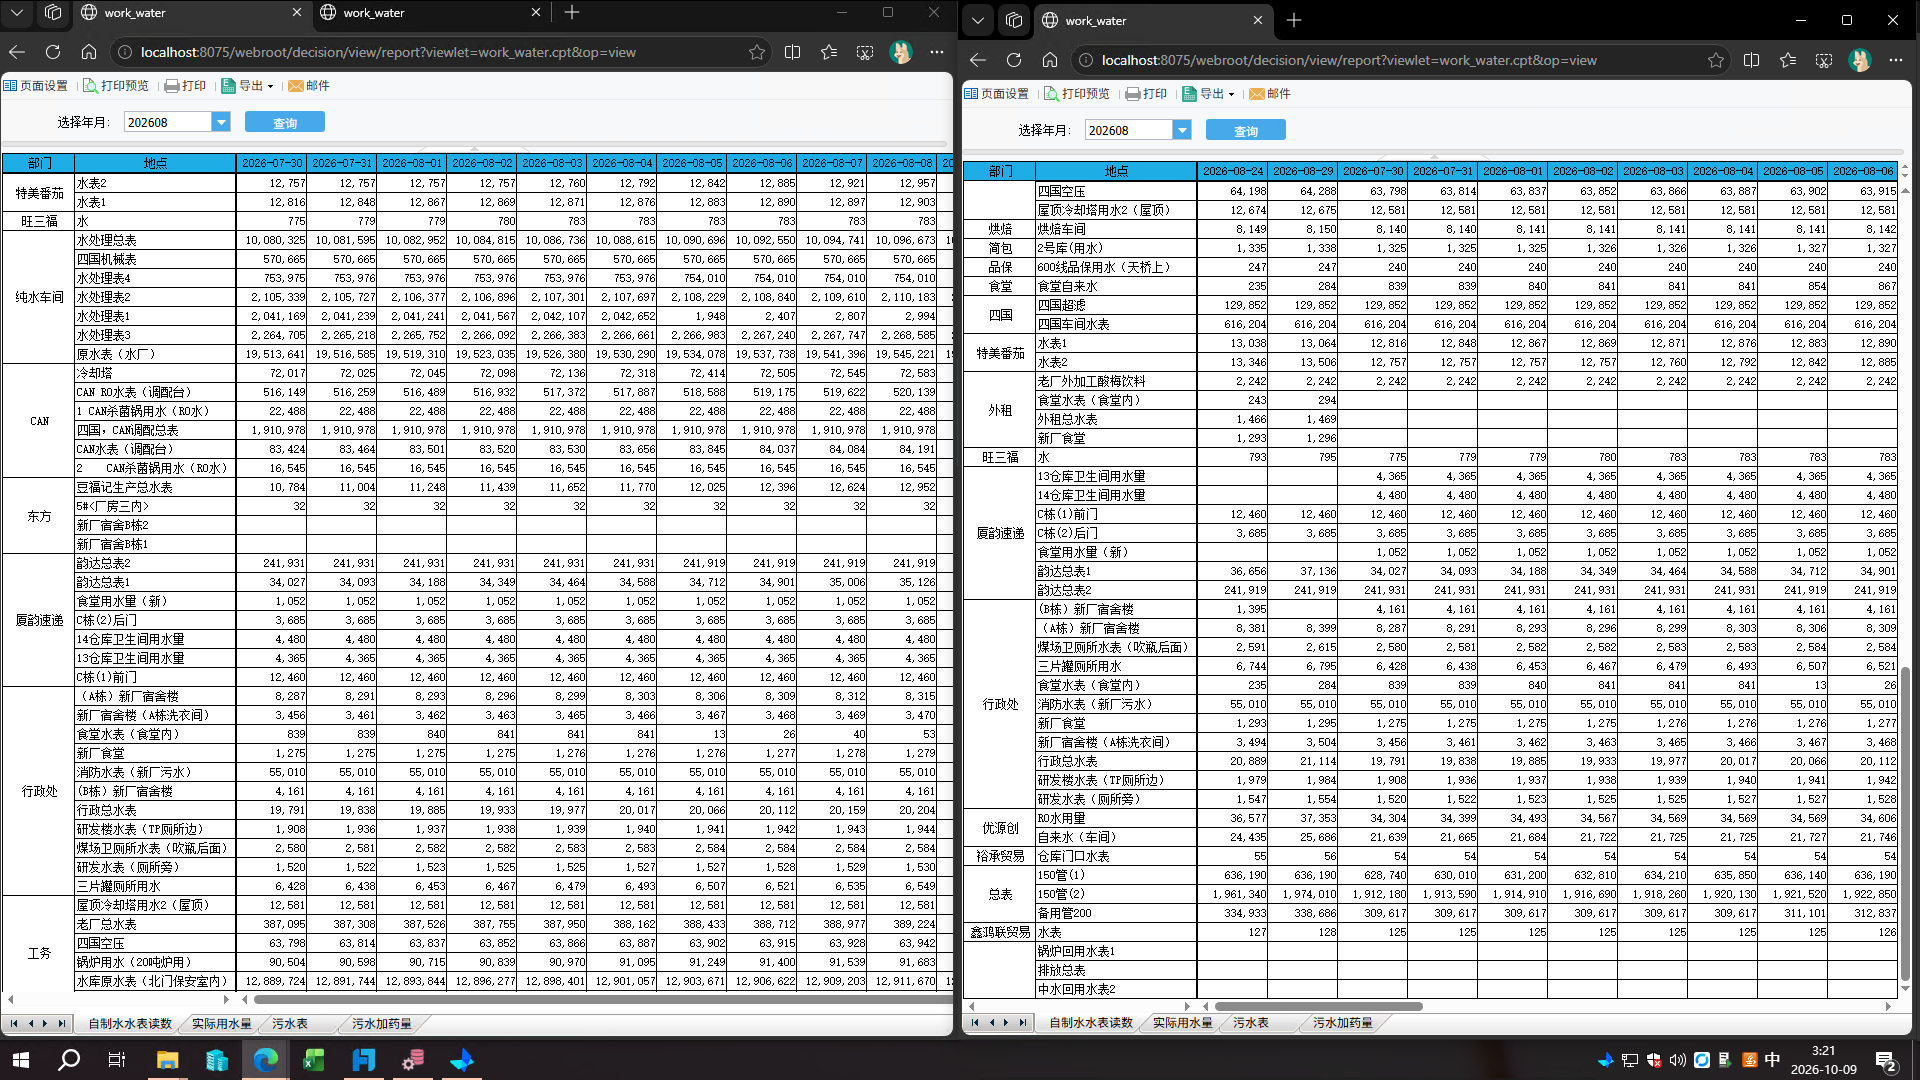
✅ 教训: 排序不能依赖数据顺序的巧合;自检法——临时改降序,列头整体反转=设置通路正常,毫无变化=选错格子或没保存。
坑 #5:单边清洗导致同一块表拆成两行
- 现象:
1#&t: 厂房 三内>与1#〈 厂房 三内〉成对出现,各带一段日期。 - 真因: 只洗新表显示名,旧表显示原样,判重键永远对不上。
- 修复: 对称清洗——键与显示、新表与旧表,全部过同一套规则;洗完都变
1#厂房三内,NOT EXISTS 命中,报表自动合并成一行、日期连续。
✅ 教训: 凡是"合并/去重/匹配"场景,归一化必须对称。只洗一边等于没洗。
坑 #6:误判教训 —— "09-27 排最前"不是脏数据
- 现象: 仅 9 月的 09-27 前置,第一反应是隐形前缀字符。
- 验证: dump 逐字节证明干净(Typ=96 Len=10,无任何前缀字节),假说撤销。
- 真因: 坑 #4(列头未升序)+ 坑 #5(判重失败拆两行,09-27 数值挂在脏名行里,干净名列自然全空)。
select METERDATE, dump(METERDATE,1016) from oaadmin.uf_water_report
 where trim(METERDATE) = '2026-09-27';
-- Typ=96 Len=10: 32,30,32,36,2d,30,39,2d,32,37 → 干干净净的 "2026-09-27",共 77 行
✅ 教训: 先拿 dump 之类硬证据说话再下结论;一次误判可能引发一次错误的 UPDATE。
坑 #7:只读账号 READOA 断掉源头治理的路
- 现象: 备份表 + UPDATE 清洗源表报权限不足。
- 原因: 账号名就是答案——READ OA。
- 决策: 源头清理脚本转交 OA 管理员用 oaadmin 执行;报表层 SQL 清洗升级为唯一防线,且必须幂等(对干净数据零影响、可反复执行)。
✅ 教训: 账号权限是方案设计的前置输入;名字里带 READ 的账号,别指望它写库。
坑 #8:占位符注释被字面粘贴 —— 空 CTE 直接报错
- 现象: 对称清洗版交付后报错,随后"两个数据集都查不到数据"。
- 真因: 交付物里写了
/* 与上面完全相同的 s/e/bad 三列 */,用户整段复制。括号里只有注释,CTE 为空,语法必然错;数据集报错在页面上的表现就是"行在数空"。
✅ 教训: 给别人的 SQL 必须零占位符、整段复制即用;文档里的"同上/略"是事故源头。
坑 #9:ORA-01790 —— UNION ALL 两侧类型不一致
- 现象: 诊断 SQL 里
fd.lastrecord(NUMBER)与to_char(w.METERDATA)对接报错。 - 修复: 两侧统一 to_char;同时把
trim(=)改like '%9-27%'补上 trim 盲区。
✅ 教训: UNION ALL 不是拼接文本,两侧逐列类型必须一致;诊断 SQL 也要讲类型纪律。
坑 #10:trim 只去空格 —— 不可见空白三兄弟
- 要点: trim() 对 Tab(chr 9)、不换行空格(chr 160)、全角空格(chr 12288) 无效,必须写进正则;CHAR 型字段有尾随空格填充问题,判重统一 trim;
&一律 chr(38)、全角字符写字面量、不用 unistr——每个构件只用验证过的写法。
'[[:space:]]|' || chr(160) || '|' || chr(12288)
五、两版 SQL 详细对比(小白版)
5.1 一句话总结
原版 = 只抄一本账(旧表),拿完数据就完事。 防呆版 = 把新旧两本账合起来抄;抄之前先把两本账的"写法"洗干净;抄的时候防止重复记账;最后按固定顺序码放整齐。
数据来源从 1 张表变成 2 张表,中间加了 4 个"临时工序":p → old_rows → old_keys → new_rows。
5.2 总览对比表
| 对比项 | 原版 | 防呆版 | 改动原因(踩过的坑) |
|---|---|---|---|
| 数据来源 | 只有旧表 328 | 旧表 + 新表 uf_water_report 合并 | 新表 8 月下旬启用,原版查不到新数据 |
| 字段清洗 | 无,原样输出 | 日期/部门/表位都过清洗规则 | &t:、>、〈〉、空格等脏字符 |
| 新表自身去重 | 无(不涉及新表) | 同表同天只留最新一条 | 新表可能重复导入 |
| 新旧判重 | 无 | NOT EXISTS 对照旧表名单 | 切换期同一天两表都有账,会记重 |
| 排序 | order by fd.mainid | order by 部门,表位,日期 | mainid 新表没有;要配合列头升序 |
| 日期参数 | WHERE 里 2 个子查询 | p 里一次算好 s、e | 复用,避免重复计算 |
| 性能保障 | 无 | materialize + 旧表先按月过滤 | 修复过"执行时间过长"超时 |
没变的部分: 查的表、字段含义、factory = 0 筛选、"读数含前一天(startime-1)、用水量不含前一天"的口径——全部原样保留。
5.3 逐块拆解(代码 + 人话)
第 0 块:with p as —— 开工前先写一张"便签"
with p as (
      select to_date(startime,'yyyy-MM-dd') as s,   -- 月起始日
             to_date(endtime,'yyyy-MM-dd')  as e,   -- 月结束日
             chr(38)||'gt;|' || ... || '?'  as bad  -- 清洗规则清单
        from oaadmin.uf_monthly_balance
       where yearmonth = '${yearmonth}'
     ),
人话: with ... as 叫 CTE(公用表表达式),作用是"先算好一个中间结果,起个名字,后面随取随用"。便签 p 上有 3 格:s、e(起止日期,所有日期过滤引用它)和 bad(要删的东西清单)。
| bad 里的规则 | 它是什么 | 怎么来的 |
|---|---|---|
> < |
">" "<" 的 HTML 转义写法 | 表单富文本控件残留 |
&t: &t: |
字面字符串(半/全角冒号两种) | 表位名被污染的实际样子 |
[[:space:]] |
空格、Tab、换行 | 复制粘贴带入 |
| chr(160)、chr(12288) | 不换行空格、全角空格 | 网页复制常见,肉眼不可见 |
[<>?] |
裸的 < > ? | 转义只删一半的残骸 |
| 〈 〉 → ? | 全角书名号、箭头、全角问号 | 输入法/粘贴产物 |
chr(38) 就是 & 字符本身——防 PL/SQL Developer 误判为变量替换(坑 #1)。清洗只发生在查询结果的显示和比对上,数据库原始数据一个字都不改。
第 1 块:old_rows —— 旧表部分(和原版几乎一样)
old_rows as (
  select trim(regexp_replace(f.METERDATE, p.bad, '')) as METERDATE,   -- ← 唯一区别:先洗再出
         trim(regexp_replace(fd.location2, p.bad, '')) as location2,
         trim(regexp_replace(fd.location,  p.bad, '')) as location,
         fd.lastrecord
    from oaadmin.formtable_main_328 f, oaadmin.formtable_main_328_dt1 fd, p
   where f.id = fd.mainid
     and f.factory = 0
     and to_date(f.readdate,'yyyy-MM-dd') between p.s - 1 and p.e
),
人话: 把原版的 from...where 原封不动搬进来,只多一件事——输出的日期、部门、表位先过 bad 清洗。regexp_replace(字段, p.bad, '') = 把匹配清单的字符全删掉;trim 再掐头去尾双保险。为什么旧表也要洗?——对称:旧表的 1#〈 厂房 三内〉 和新表的 1#&t: 厂房 三内> 洗完都变 1#厂房三内,才认得出是同一块表。
第 2 块:old_keys —— 旧表的"已记账名单"
old_keys as (
  select /*+ materialize */ distinct METERDATE, location2, location from old_rows
),
人话: 把旧表当月出现过的所有"日期+部门+表位"组合去重成名单。distinct 去重;/*+ materialize */ 提示 Oracle 先算好放临时区——这是修复超时的关键:合账时每条新表记录都查这份小名单,速度快。注意:旧表数据本身不去重(一行不少地展示),去重的只是名单。
第 3 块:new_rows —— 新表部分 + 自己先去重
new_rows as (
  select METERDATE, location2, location, METERDATA,
         row_number() over (partition by METERDATE, location2, location
                            order by ID desc) as rn
    from ( ...从 uf_water_report 取数,同样先清洗,同样按 p.s-1~p.e 过滤... )
),
人话: row_number() 给同一块表同一天的几条记录编号,ID 最大的(最新录入)编 1 号,后面只取 rn=1。解决新表重复导入问题。
第 4 块:主查询 —— 合账
select ... from ( select ... from old_rows                   -- ① 旧表全部保留
                  union all                                  -- ② 上下两摞叠起来
                  select ... from new_rows
                   where rn = 1                              -- ③ 新表只留最新
                     and not exists (select 1 from old_keys k -- ④ 名单里查无此人
                                      where k.METERDATE = new_rows.METERDATE
                                        and k.location2 = new_rows.location2
                                        and k.location  = new_rows.location))
人话: 合账三条规则——旧表一行不动;新表先去内部重复;再拿每条新记录的三键去旧表名单里找,找得到=旧表已记过→丢弃(防重),找不到=新记录→补进来。union all 就是两摞数据上下叠;not exists 就是"查无此人才放行"。
第 5 块:用水量独有的 userecord 计算
w.METERDATA - nvl(to_number(trim(regexp_replace(w.LASTRECORD, p.bad, ''))), w.METERDATA) as userecord
人话: 旧表用水量是现成字段直接取;新表存的是读数,要自己算"本次 − 上次"。nvl 兜底:上次读数为空或不是数字时按差值 0 处理,避免整行报错。
第 6 块:order by 的变化
| 原版 | 防呆版 | |
|---|---|---|
| 写法 | order by fd.mainid | order by location2, location, 日期 |
| 含义 | 按旧表录入批次号排 | 先部门、再表位、最后日期 |
| 问题 | mainid 新表没有;顺序与报表分组无关 | 行序与报表"部门→地点"分组对齐,配合列头升序,两个方向都稳 |
5.4 问题 ↔ 代码对照表
| 曾经的问题 | 防呆版里的修复 |
|---|---|
| 新表数据查不到 | new_rows 分支 + union all |
| 同一块表拆两行 / 同一天两笔账 | 对称清洗 + old_keys 名单 + not exists |
&t:、>、〈〉 脏字符 |
p.bad 清洗规则,全程引用 |
| 新表重复导入 | row_number() 取 rn=1 |
| 查询超时 | materialize + 旧表先按月过滤再进名单 |
| 列头乱序(SQL 侧那一半) | order by 部门→表位→日期(列头本身靠帆软"升序") |
5.5 小白名词卡
| 名词 | 一句话解释 |
|---|---|
| with...as(CTE) | 给中间查询结果起名字,后面反复引用,像先打好草稿 |
| regexp_replace(字段,模式,'') | 按模式把字符删掉,模式里 | 分隔多个目标 |
| trim() | 掐掉首尾空格(对 Tab/chr160 无效,见坑 #10) |
| row_number() over(partition by A order by B) | 按 A 分组、组内按 B 排序编号,取 1 号=每组留一条 |
| not exists | "不存在匹配记录"才通过,用于合账查重 |
| union all | 两段查询结果直接上下叠加(不去重) |
| /+ materialize / | 提示数据库先算好放临时区,重复引用时提速 |
| chr(38) | 字符 & 的转义写法,防工具误判 |
| dump(x,1016) | 显示值的真实字节,隐形字符现形器 |
5.6 记忆比喻:一个认真的会计
旧表 = 纸质登记簿:历史都在,写法偶有潦草(脏字符); 新表 = 新上马的抄表机:字迹乱(
&t:),且可能重复打印; 防呆版 SQL = 认真的会计:先把两本账字迹描清楚(清洗)→ 登记簿全数誊抄(old_rows)→ 抄表机新账先去掉重复页(rn=1)→ 每页和登记簿核对,登过的不重抄、没登的补上(not exists)→ 最后按部门、表位、日期码放整齐(order by)。 原版那个会计只誊了登记簿一本就下班了——这就是全部区别。
六、最终交付 SQL(防呆完整版,整段可粘贴)
特征:零占位符;& 用 chr(38) 拼;全角字符直接写字面量;两个数据集的 p 一字不差。在帆软数据集里直接用(走 JDBC);若在 PL/SQL 测试,先 set define off 并把 '${yearmonth}' 换成 '202609'。
6.1 水表读数
with p as (
      select to_date(startime,'yyyy-MM-dd') as s,
             to_date(endtime,'yyyy-MM-dd')  as e,
             chr(38)||'gt;|' || chr(38)||'lt;|' || chr(38)||'t:|' || chr(38)||'t:|[[:space:]]|'
               || chr(160) || '|' || chr(12288) || '|[<>?]|〈|〉|→|?'  as bad
        from oaadmin.uf_monthly_balance
       where yearmonth = '${yearmonth}'
     ),
     old_rows as (
      select trim(regexp_replace(f.METERDATE, p.bad, ''))  as METERDATE,
             trim(regexp_replace(fd.location2, p.bad, '')) as location2,
             trim(regexp_replace(fd.location,  p.bad, '')) as location,
             fd.lastrecord
        from oaadmin.formtable_main_328 f,
             oaadmin.formtable_main_328_dt1 fd,
             p
       where f.id = fd.mainid
         and f.factory = 0
         and to_date(f.readdate,'yyyy-MM-dd') between p.s - 1 and p.e
     ),
     old_keys as (
      select /*+ materialize */ distinct METERDATE, location2, location from old_rows
     ),
     new_rows as (
      select METERDATE, location2, location, METERDATA,
             row_number() over (partition by METERDATE, location2, location
                                order by ID desc) as rn
        from (select trim(regexp_replace(w.METERDATE,  p.bad, '')) as METERDATE,
                     trim(regexp_replace(w.LOCATION2, p.bad, '')) as location2,
                     trim(regexp_replace(w.LOCATION,  p.bad, '')) as location,
                     w.METERDATA, w.ID
                from oaadmin.uf_water_report w, p
               where to_date(trim(regexp_replace(w.METERDATE, p.bad, '')),'yyyy-MM-dd')
                       between p.s - 1 and p.e)
     )
select METERDATE, location2, location, lastrecord
  from (select METERDATE, location2, location, lastrecord from old_rows
        union all
        select METERDATE, location2, location, METERDATA as lastrecord
          from new_rows
         where rn = 1
           and not exists (select 1 from old_keys k
                            where k.METERDATE = new_rows.METERDATE
                              and k.location2 = new_rows.location2
                              and k.location  = new_rows.location))
 order by location2, location, METERDATE
6.2 用水量(同构,仅日期口径与取值不同)
with p as (
      select to_date(startime,'yyyy-MM-dd') as s,
             to_date(endtime,'yyyy-MM-dd')  as e,
             chr(38)||'gt;|' || chr(38)||'lt;|' || chr(38)||'t:|' || chr(38)||'t:|[[:space:]]|'
               || chr(160) || '|' || chr(12288) || '|[<>?]|〈|〉|→|?'  as bad
        from oaadmin.uf_monthly_balance
       where yearmonth = '${yearmonth}'
     ),
     old_rows as (
      select trim(regexp_replace(f.readdate, p.bad, ''))   as readdate,
             trim(regexp_replace(fd.location2, p.bad, '')) as location2,
             trim(regexp_replace(fd.location,  p.bad, '')) as location,
             fd.userecord
        from oaadmin.formtable_main_328 f,
             oaadmin.formtable_main_328_dt1 fd,
             p
       where f.id = fd.mainid
         and f.factory = 0
         and to_date(f.readdate,'yyyy-MM-dd') between p.s and p.e
     ),
     old_keys as (
      select /*+ materialize */ distinct readdate, location2, location from old_rows
     ),
     new_rows as (
      select readdate, location2, location, userecord,
             row_number() over (partition by readdate, location2, location
                                order by ID desc) as rn
        from (select trim(regexp_replace(w.METERDATE,  p.bad, '')) as readdate,
                     trim(regexp_replace(w.LOCATION2, p.bad, ''))  as location2,
                     trim(regexp_replace(w.LOCATION,  p.bad, ''))  as location,
                     w.METERDATA
                       - nvl(to_number(trim(regexp_replace(w.LASTRECORD, p.bad, ''))),
                             w.METERDATA) as userecord,
                     w.ID
                from oaadmin.uf_water_report w, p
               where to_date(trim(regexp_replace(w.METERDATE, p.bad, '')),'yyyy-MM-dd')
                       between p.s and p.e)
     )
select readdate, location2, location, userecord
  from (select readdate, location2, location, userecord from old_rows
        union all
        select readdate, location2, location, userecord
          from new_rows
         where rn = 1
           and not exists (select 1 from old_keys k
                            where k.readdate  = new_rows.readdate
                              and k.location2 = new_rows.location2
                              and k.location  = new_rows.location))
 order by location2, location, readdate
▲ 原版 SQL 作为对照留档:读数/用水量均只查 formtable_main_328 系表,order by fd.mainid,无新表、无清洗、无判重。
七、验收清单
| # | 验收项 | 方法 |
|---|---|---|
| 1 | 成对脏名行合并为一行,日期连续 | 看此前 4#厂房四内(消防表)、1#&t:... 等表位 |
| 2 | 列头严格升序 | 8 月从 07-30 起;9 月 09-27 归位且数值填充 |
| 3 | 脏字符绝迹 | 页面 Ctrl+F 搜 & 和 〈,无结果 |
| 4 | 其他月份零变化 | 清洗对干净数据是恒等变换 |
| 5 | 行数守恒 | 合并后 = 旧表行数 + 新表去重行数 − 重叠行数 |
| 6 | 性能 | 数据集预览秒级返回 |
八、七条经验
| # | 经验 | 对应坑 |
|---|---|---|
| 1 | 归一化必须对称:匹配/合并场景,两边键过同一套清洗;显示与键用同一套清洗 | #5 |
| 2 | SQL 层清洗是最后防线:账号只读、源头治理无期时,幂等清洗既兜底又可回退 | #7 |
| 3 | 报表排序别赌运气:列头顺序显式设置;"原序"的正常往往只是数据顺序的巧合 | #4 |
| 4 | 诊断先于结论:dump / all_objects / distinct 盘点,用字节级证据代替猜测 | #6 |
| 5 | 连接键上不套函数:先过滤、先归一、先物化,再反连接 | #3 |
| 6 | 两个数据集永远同版本:读数与用水量清洗规则一字不差,否则判重口径漂移 | #5/#8 |
| 7 | 交付物零占位符:SQL 整段复制即用;& 用 chr(38)、全角写字面量、不用未验证构件 |
#1/#8/#10 |
附录:诊断工具箱
-- ① 对象存在性裁判
select owner, object_name, status from all_objects where object_name = '...';

-- ② 同库确认(帆软连接与 PL/SQL 各跑一次,结果一致才是同库)
select user, sys_context('USERENV','DB_NAME') db_name,
       sys_context('USERENV','SERVER_HOST') host from dual;

-- ③ 字节级看"隐形字符"(20=空格 09=Tab a0=chr160)
select METERDATE, dump(METERDATE,1016) dmp, count(*) cnt
  from oaadmin.uf_water_report group by METERDATE, dump(METERDATE,1016);

-- ④ 脏值全量盘点(任何变体都逃不掉)
select METERDATE, dump(METERDATE,1016), count(*)
  from oaadmin.uf_water_report
 where not regexp_like(trim(METERDATE), '^[0-9]{4}-[0-9]{2}-[0-9]{2}$')
 group by METERDATE, dump(METERDATE,1016);

-- ⑤ 复现报表列头的输入序列(第一行是什么,列头最前面就是什么)
with p as (select to_date(startime,'yyyy-MM-dd') s, to_date(endtime,'yyyy-MM-dd') e
             from oaadmin.uf_monthly_balance where yearmonth='202609')
select distinct trim(w.METERDATE) d
  from oaadmin.uf_water_report w, p
 where to_date(trim(w.METERDATE),'yyyy-MM-dd') between p.s - 1 and p.e
 order by d;
—— 全文完 · 基于真实排障对话整理 · 若你也在做双系统并行期的数据合并,欢迎对照踩坑清单逐条自检